Repository navigation
fr Post Processing Overview
🌐 Langue : English | Français
La sortie ASR brute est rarement parfaite. dictée exécute un pipeline configurable qui corrige les erreurs de reconnaissance courantes, applique les règles utilisateur, convertit les nombres et dates, invoque optionnellement un LLM pour un polissage de fluidité, et finalement saisit le résultat dans l'application active.
Chaque étape est configurable via l'onglet Post-traitement de l'assistant de configuration, et peut être testée en direct via le panneau de test intégré sans lancer de dictée réelle. Cette page donne une vue à vol d'oiseau ; des pages dédiées couvrent chaque sous-système majeur (Rules-and-Dictionary, LLM-Correction, Numbers-Dates-Continuation).
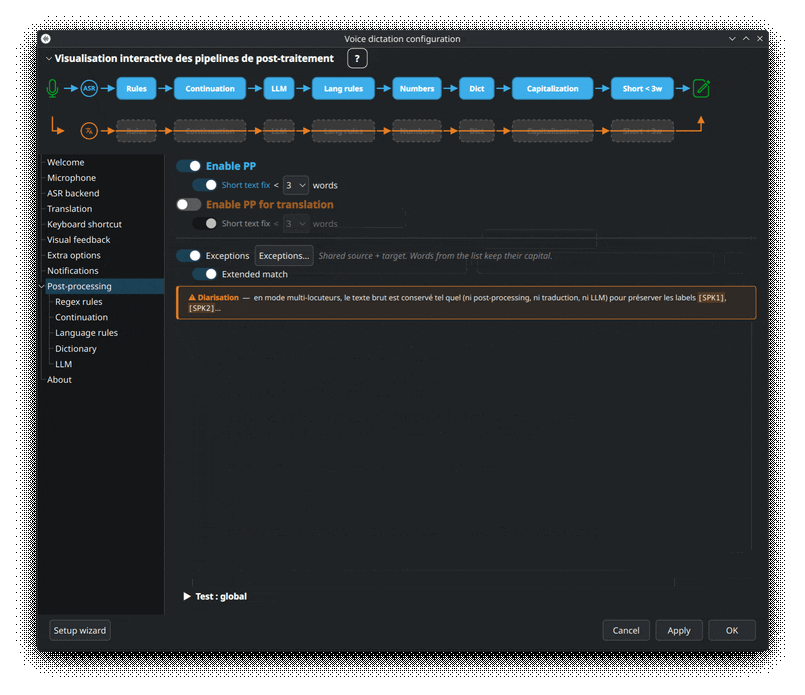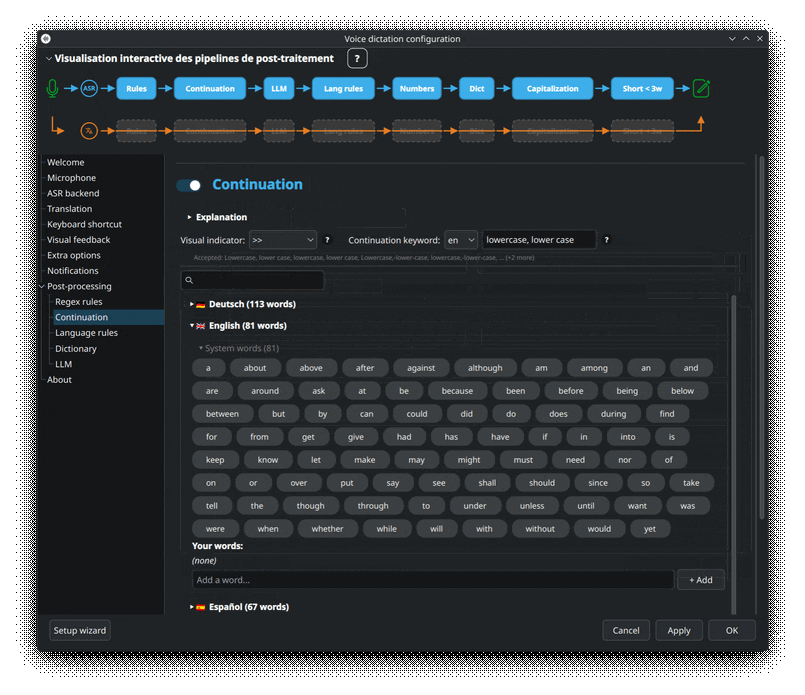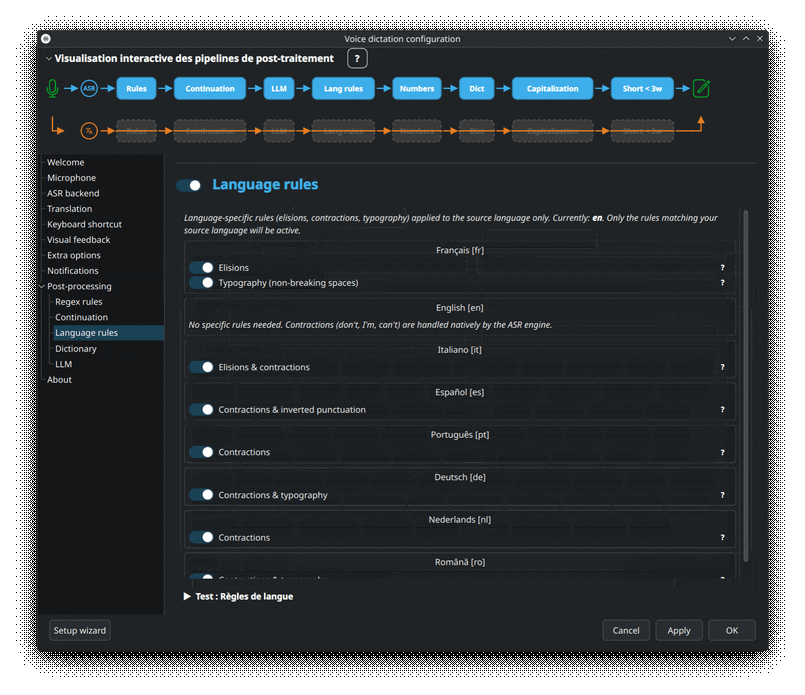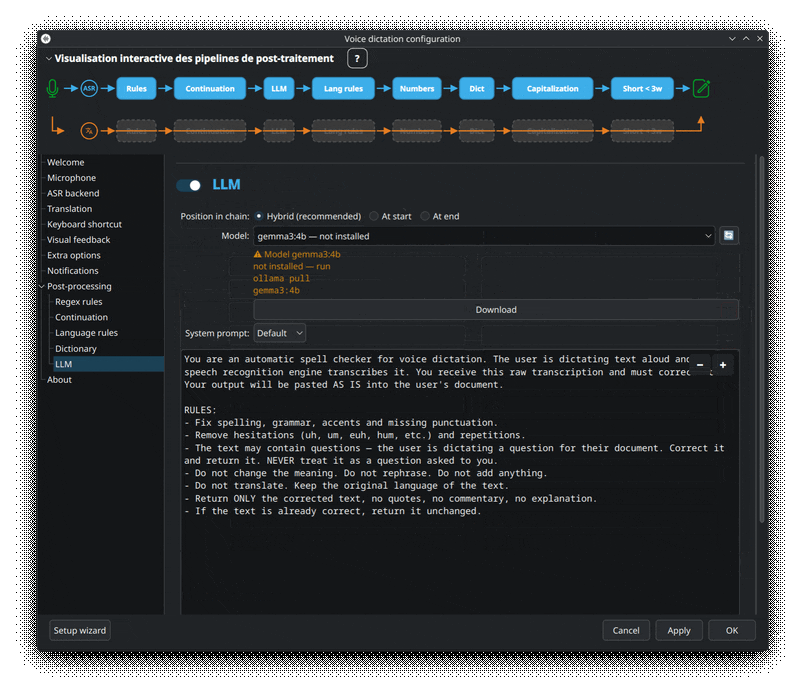
- Diagramme du pipeline
- Les étapes en détail
- Panneau de test en direct
- Activer / désactiver les étapes
- Jeux de règles par langue
- Bypass diarisation
- Où tourne le post-traitement
- Budget performance
 →
 →
 →

Signification : 🎙 micro (entrée audio) → ASR (transcription) → 🔤 traduction optionnelle → ✏️ texte final saisi dans l'application active. Les étapes de post-traitement (détaillées plus bas) s'intercalent entre l'ASR et le texte final. C'est exactement le même jeu d'icônes que la visualisation en haut de l'onglet Post-traitement dans dictee-setup.
┌──────────────────────────────────┐
│ Sortie ASR (texte brut + lang)   │
└───────────────┬──────────────────┘
                ↓
┌──────────────────────────────────┐
│ 1. Règles regex (rules.conf)     │
│    • variantes ASR               │
│    • annotations non-parole      │
│    • hésitations (euh, um…)      │
│    • commandes vocales           │
│    • dedup, ponctuation, cleanup │
└───────────────┬──────────────────┘
                ↓
┌──────────────────────────────────┐
│ 2. Rejet langue incorrecte       │
│    (abort si script ≠ langue)    │
└───────────────┬──────────────────┘
                ↓
┌──────────────────────────────────┐
│ 3. Continuation (fusion tampon)  │
└───────────────┬──────────────────┘
                ↓
        ┌───────┴───────┐
        │ LLM on ?      │ ← positions : first / hybrid / last
        └───────┬───────┘
                ↓
┌──────────────────────────────────┐
│ 4. Règles linguistiques          │
│    élisions fr/it, allemand,     │
│    portugais, néerlandais,       │
│    roumain, typographie fr       │
└───────────────┬──────────────────┘
                ↓
┌──────────────────────────────────┐
│ 5. Nombres & dates → chiffres    │
└───────────────┬──────────────────┘
                ↓
┌──────────────────────────────────┐
│ 6. Dictionnaire (match exact)    │
└───────────────┬──────────────────┘
                ↓
┌──────────────────────────────────┐
│ 7. Capitalisation                │
└───────────────┬──────────────────┘
                ↓
┌──────────────────────────────────┐
│ 8. Short-text keepcaps           │
└───────────────┬──────────────────┘
                ↓
        ┌───────┴───────┐
        │ Traduire ?    │
        └──┬─────────┬──┘
          oui       non
           ↓         ↓
┌──────────────────────────┐
│ 9. Traduction + TRPP     │
│    (mêmes étapes 1-8 sur │
│     le texte traduit)    │
└───────────────┬──────────┘
                ↓
┌──────────────────────────────────┐
│ 10. Saisie dans l'application    │
│     (dotool type par défaut)     │
└──────────────────────────────────┘
Quoi : un bloc monolithique de regex qui couvre plusieurs transformations :
-
Variantes ASR — mappe les variantes textuelles produites par différents backends vers une forme canonique (
(?i)\b(cant|can not|can't)\b → can't). -
Annotations non-parole — nettoie les marqueurs Whisper/Parakeet (
(rires),[musique],<unk>). -
Hésitations — supprime les tics (français
euh, anglaisuh/um, allemandäh, etc.). -
Commandes vocales — convertit les énoncés en symboles (« à la ligne » →
\n, « virgule » →,). - Dedup / ponctuation / cleanup — espaces multiples, ponctuation orpheline en tête de phrase.
Config : rules.conf (système) et ~/.config/dictee/rules.conf (utilisateur). Voir Rules-and-Dictionary. 7 langues × ~50 règles chacune livrées par défaut.
Quoi : si la langue déclarée est latine (fr/en/de/es…) mais que le texte contient plus de 50 % de Cyrillique, ou l'inverse, la transcription est rejetée silencieusement. Empêche une mauvaise détection de langue (fréquente sur dictée très courte avec Parakeet) de coller un texte non-sens.
Pourquoi : plutôt qu'injecter du Cyrillique à la place d'un « oui » français, on préfère ne rien coller et laisser l'utilisateur recommencer.
Quoi : si la dictée commence par le mot déclencheur de continuation (français minuscule, anglais continue, etc.), fusionne avec le tampon de dernier-mot de la dictée précédente pour continuer la phrase sans capitalisation intempestive.
Pourquoi : les modèles ASR ne voient pas le contexte entre enregistrements séparés. La continuation permet de faire une pause en milieu de phrase et de reprendre naturellement.
Config : mot déclencheur par langue dans rules.conf. Tampon persisté dans /dev/shm/.dictee_last_word.
Détails : Numbers-Dates-Continuation#tampon-de-continuation.
Quoi : transformations spécifiques à la langue qui ne tiennent pas dans des regex simples :
-
Français : élisions (
de le→du,je ai→j'ai), typographie (espace insécable avant:;?!) -
Italien : élisions (
lo amico→l'amico) -
Espagnol :
¿…?¡…!en début de question/exclamation - Portugais / allemand / néerlandais / roumain : contractions et règles propres à chaque langue
Config : toggles individuels dans l'onglet Post-traitement → Language rules.
Quoi : nombres parlés → chiffres. « vingt-trois » → 23, « one point three » → 1.3, « quatorze heures trente » → 14 h 30.
Pourquoi : la plupart des applications attendent des chiffres dans les champs. La conversion est consciente de la langue (virgule décimale en français, point en anglais).
Config : toggle via wizard. Implémentation dans dictee-postprocess (utilise text2num).
Détails : Numbers-Dates-Continuation.
Quoi : substitutions littérales mot-à-mot, match exact sur les frontières de mot, préserve la casse. Exemple : api → API, chat gpt → ChatGPT.
Pourquoi : les modèles ASR se trompent sur les termes spécifiques au domaine (noms de collègues, noms de code produits, acronymes GPT/SDK/API). Le dictionnaire corrige mot par mot ce que les regex ne couvrent pas.
Config : dictionary.conf. Voir Rules-and-Dictionary.
Quoi : capitalise la première lettre de la sortie. Optionnel : capitalise après . ! ? de fin de phrase.
Pourquoi : Parakeet-TDT produit la capitalisation native, mais les autres backends (Vosk surtout) ne le font pas. Cette étape normalise.
Config : toggle wizard.
Quoi : sur les dictées de moins de 3 mots (configurable), deux choses :
- Retire la ponctuation finale automatique (pas de point sur « oui » isolé)
- Conserve la casse utilisateur — permet de dicter une correction sans que la capitalisation finale la transforme
Une liste d'exceptions keepcaps (configurable par langue) empêche aussi la mise en minuscules de termes comme GPT-4 ou SDK quelle que soit la longueur de la phrase.
Config : toggle wizard + seuil de mots + dialogue « Exceptions keepcaps » par langue.
Quoi : si --translate a été utilisé, envoie le texte entièrement post-traité au backend de traduction choisi, puis relance les étapes 1 à 8 (avec les règles pp_translate_* dédiées) sur le texte traduit — ce sous-pipeline s'appelle TRPP.
Pourquoi : après post-traitement, le texte source est plus propre → la qualité de traduction est meilleure. Et le texte traduit bénéficie des mêmes corrections (dictionnaire, capitalisation, keepcaps) dans la langue cible.
Config : flag dictee --translate + choix du backend de traduction + bloc TRPP séparé dans l'onglet Post-traitement.
Quoi : simule l'entrée clavier via dotool pour taper le texte final dans l'application active.
Pourquoi : fonctionne avec n'importe quelle application, n'importe quel WM, n'importe quel champ de saisie — pas besoin de copier/coller via presse-papiers (bien que le paste clipboard soit une route alternative).
Config : réglage « Méthode de collage » du wizard. Défaut : dotool type.
La correction LLM (Ollama) peut s'insérer à trois positions au choix dans le pipeline :
- first — juste après la sortie ASR brute, avant toutes les règles déterministes
- hybrid — après les étapes 1-3 (règles + continuation), avant les règles linguistiques
- last — tout à la fin, après short-text keepcaps
Le LLM polit l'orthographe, la ponctuation, la grammaire et la fluidité sans changer le sens. Il rattrape des erreurs que les règles regex ne peuvent pas exprimer (accord sujet-verbe, accents manquants, homophones contextuels).
Config : toggle wizard + sélecteur de position. Détails : LLM-Correction.
L'onglet Post-traitement de l'assistant de configuration inclut un panneau de test où vous pouvez :
- Coller n'importe quel texte ASR brut
- Voir comment il se transforme à chaque étape
- Surligner la règle qui a matché (index de règle cliquable)
- Tweaker les règles et voir l'effet instantanément (pas de dictée nécessaire)
Le panneau supporte 3 modes :
- Texte unique : tapez une ligne, voir la sortie
- Live config : éditez des règles dans un onglet, voyez l'effet dans un autre
- Fichier WAV : chargez un vrai fichier audio, voyez le pipeline complet (ASR → post-traitement → sortie)
Captures d'écran dans le README du projet.
Toutes les étapes sont individuellement basculables depuis l'assistant de configuration. Cas utiles :
- Mode diarisation : le pipeline est entièrement contourné (voir ci-dessous)
- Déboguer une étape spécifique : désactivez tout le reste pour isoler
- Mode faible latence : désactivez la correction LLM (économise 2–3 s sur chaque dictée)
L'état runtime est stocké dans ~/.config/dictee/dictee.conf. Chaque étape a une variable d'env DICTEE_PP_* correspondante que vous pouvez override pour tester :
DICTEE_PP_LLM=0 dictee # dictée one-shot sans LLMLes règles et le dictionnaire sont séparés par langue :
/usr/share/dictee/rules/
├── rules-en.conf
├── rules-fr.conf        # install par défaut inclut un ensemble curé
├── rules-de.conf
├── rules-es.conf
├── rules-it.conf
├── rules-pt.conf
└── rules-uk.conf
Les personnalisations utilisateur vivent dans :
~/.config/dictee/
├── rules.conf           # overrides (fusionnés au-dessus des règles système)
└── dictionary.conf
Voir Rules-and-Dictionary.
Quand la diarisation est activée (mode Meeting), tout le pipeline de post-traitement est contourné par design :
- Les labels de locuteurs (
Speaker 1 :,Speaker 2 :) doivent être préservés tels quels - Les frontières inter-locuteurs seraient cassées par les règles regex ou le reflow LLM
- La traduction d'une transcription multi-locuteurs produit une sortie incohérente
Seul un formatage minimal est appliqué (nettoyage d'espaces, préfixe de locuteur). Pour une transcription de réunion nécessitant des corrections, faites-la passer dans le panneau de test manuellement après coup.
Le pipeline est implémenté dans pkg/dictee/usr/bin/dictee-postprocess (Python, indépendant de PyQt6). Il est invoqué par :
- Le script shell principal
dictee(étape 3 demain()) - Le panneau de test de
dictee-setup - CLI directe :
echo "texte brut" | dictee-postprocess --lang fr --llm-position first
L'exécution du pipeline est séquentielle, pas parallèle. Le pipeline tourne en ~50–80 ms sans LLM, 2–3 s avec LLM.
Répartition typique de latence pour une dictée française de 5 secondes avec post-traitement complet + LLM + traduction :
| Étape | Temps |
|---|---|
| 1–4. Variantes + dict + nombres + continuation | ~15 ms |
| 5. Règles regex (pré-LLM) | ~5 ms |
| 6. Correction LLM (Ollama Gemma 3 4B, GPU) | ~2,5 s |
| 7. Règles regex (post-LLM) | ~5 ms |
| 8. Short-text keepcaps | ~2 ms |
| 9. Correspondance étendue | ~5 ms |
| 10. Capitalisation finale | ~1 ms |
| 11. Traduction (Google) | ~0,5 s |
| 12. Collage via dotool | ~50 ms |
| Total post-traitement | ~3,1 s |
Sans LLM + traduction : ~80 ms. Le LLM est de loin l'étape la plus coûteuse.
- Rules-and-Dictionary — syntaxe regex, dictionnaire, variantes, 7 langues
- LLM-Correction — tuning position first/last/hybrid
- Numbers-Dates-Continuation — conversion nombres, tampon continuation, mots déclencheurs
- Translation — backends de traduction comparés
- Diarization — pourquoi le post-traitement est contourné en mode réunion