diff --git a/2ARM_ROBOT/README.md b/2ARM_ROBOT/README.md
index ddecf234..93440ec9 100644
--- a/2ARM_ROBOT/README.md
+++ b/2ARM_ROBOT/README.md
@@ -6,6 +6,23 @@
[포트폴리오·이력서](https://julianjeonresume.netlify.app/) · [CUSTOM ACT V1 상세](docs/CUSTOM_ACT_V1_KO.md) · [그림·영상](https://julianjeonresume.netlify.app/research/custom-act-v1/) · [이전 조작 연구](docs/RESEARCH_SUMMARY_KO.md) · [실물 검토 브랜치](https://github.com/Alpenj/DAPIER/tree/pro/sweepick-review-20261015/2ARM_ROBOT/sweepick)
+
+
+
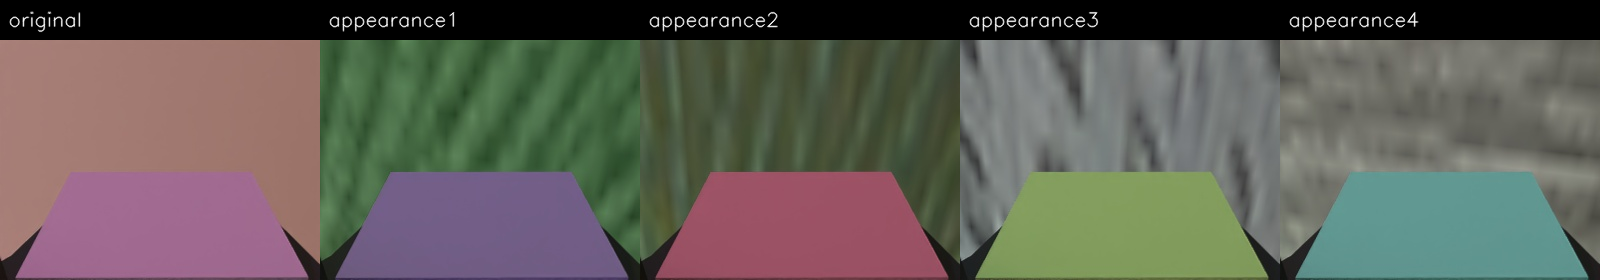
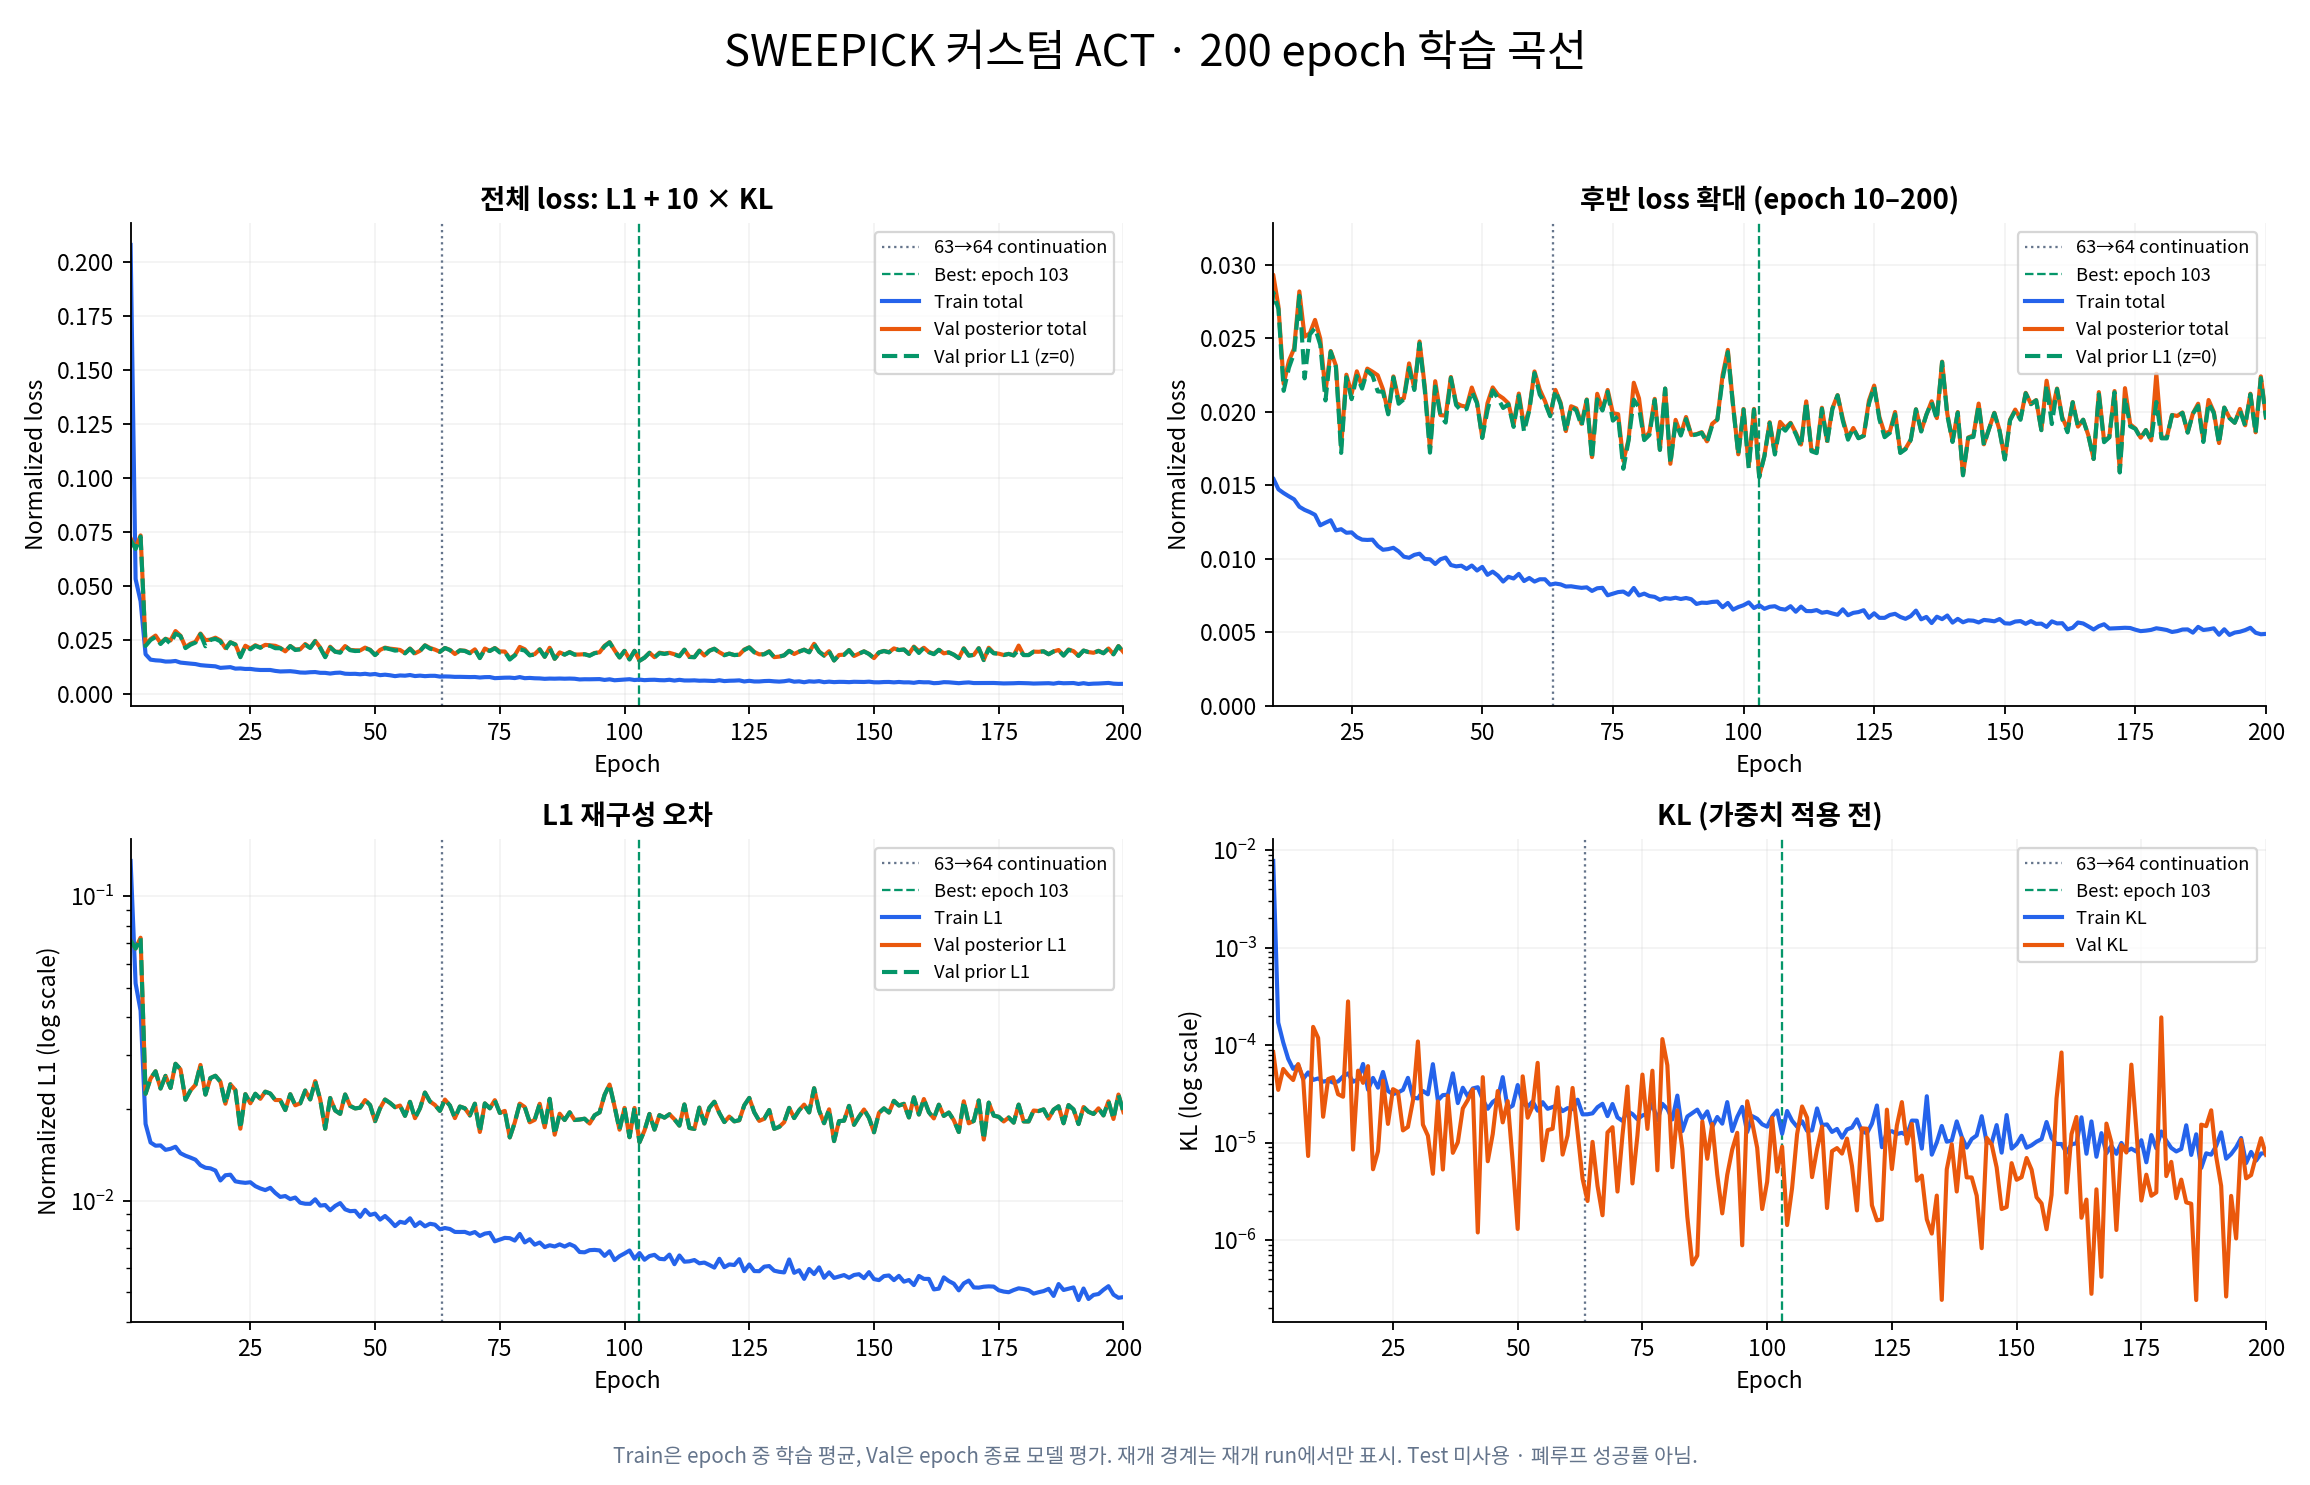
+고정 epoch30 · Test mid00_01 · [원본 영상](https://julianjeonresume.netlify.app/assets/custom-act-v1/sim-test-mid00_01.mp4) · [수집 외형](../docs/media/collection-appearances.png) · [학습 곡선](../docs/media/training-curves.png) · [영상·그림 출처](../docs/media/README.md)
+
+[핵심 결과](#custom-act-v1-데이터에서-실행까지) · [시스템 구성](#시스템-구성) · [실물 연동](#실물-데이터와-실행기-연동) · [코드 위치](#구성과-코드-위치) · [실행 안내](#실행-안내와-과거-실습) · [문서 목록](docs/README.md)
+
+## 시스템 구성
+
+관측과 행동의 단위·순서·시각을 맞추고, 학습된 정책의 출력을 실행 기록과 대조한다. 아래는 연구와 실행의 역할 구분이다. 검토 브랜치의 실물 실행기와 공개 `main`의 연구 코드는 아래 코드 위치에서 따로 연결한다.
+
+
+
+[구성도 소스](../docs/media/sweepick-system.mmd)
+
+이동 베이스의 전면 Astra RGB-D는 Visual SLAM, 작업공간 OS30A RGB-D와 손목 RGB는 조작 관측에 사용한다. 센서의 역할과 관절·좌표 계약을 구분해 연결한다.
+
## CUSTOM ACT V1: 데이터에서 실행까지
학습 손실만으로 로봇의 작업 완료를 판단하기 어려웠다. 시연을 어떤 기준으로 나누었는지, 정책이 어떤 관측을 받는지, 예측한 행동 청크가 실제 명령으로 어떻게 이어지는지를 함께 기록했다.
@@ -14,11 +31,18 @@
|---|---|---|
| 데이터 수집 | 원본 113개 궤적의 동작을 유지하며 손목 RGB의 물체색·배경·테이블 텍스처·조명을 5개 외형으로 구성. 관측·상태·명령·시각 정합 확인 | 565개 뷰. 궤적 train/val/test=59/29/25, 뷰=295/145/125. 같은 궤적의 외형은 동일 분할 유지 |
| 학습 | 양손목 RGB·head PCD·관절 상태를 입력으로 사용하는 ACT 학습 | 200 epoch 완료. best validation은 epoch103, prior normalized L1=0.01553 |
-| 추론 | 별도로 고정한 epoch30 체크포인트, temporal ensemble ON(k=0.01)으로 SIM 폐루프 평가 | 143개 위치 각 1회 중 132회 완료(92.3%). Test 위치는 27/31(87.1%) |
+| 추론 | 별도로 고정한 epoch30 체크포인트, temporal ensemble ON(k=0.01)으로 SIM 폐루프 평가 | 143개 위치 각 1회, 132/143 완료(92.3%). Test 위치는 27/31(87.1%) |
| 분석 | 예측 청크의 target 시점·가중치·관절 명령·실측값·phase·영상 연결 | 실패 11회 중 grasp/lift 7회, stow 4회. 청크 집계 결과를 저장 CSV에서 재구성해 확인 |
폐루프 완료 기준은 **30 mm 이상 Lift → Stow → 물리 2초 Hold**다. 외형은 랜덤화하고 물체 크기(40 mm)·yaw·물성·카메라 보정은 고정했다. 위 92.3%는 이 SIM 조작 평가의 관측값이다. 200 epoch 최종 모델의 폐루프 결과, 실물 성공률이나 전체 청소 시나리오 성공률과 합산하지 않는다.
+
+## 실패를 조사한 방법
+
+학습 손실과 작업 완료를 따로 확인했다. 고정 epoch30 SIM 평가에서 완료하지 못한 11회는 grasp/lift 7회와 stow 4회로 나눴다. 예측값만 보고 원인을 정하지 않고 query·target 시점, 집계 가중치, 실제 전송 명령, 실측 관절과 영상을 같은 시간축에서 읽었다.
+
+기존 first-action-only 실행과 temporal ensemble의 차이도 저장 CSV로 재구성했다. 한 위치의 ON/OFF 비교와 저장 데이터의 정합성 검사는 전체 성능 향상이나 새 실물 성공률로 계산하지 않았다. [청크 집계와 비교 조건](docs/CUSTOM_ACT_V1_KO.md#4-분석--예측-청크가-명령이-되는-과정을-추적했다)에 검사 수치와 한계를 남겼다.
+
## 실물 데이터와 실행기 연동
| 트랙 | 확인된 결과 | 지표의 의미 |
@@ -30,7 +54,7 @@
10/08의 첫 무인 왼팔 집기, 10/18~23의 약170회 자동 교사 실행, 10/23의 ACT 접근 뒤 교사 마무리 기록은 위 후속 실험에 이르는 개발 이력이다. 10/26까지의 TJJ 실물 기록에서 ACT 단독 집기 완료는 관찰되지 않았다. 신규 CUSTOM ACT V1 SIM 폐루프 완료와 이 실물 기록을 혼동하지 않는다.
-10/27의 새 IR2 정지 shadow는 양팔 각300 prefix를 30초 동안 확인했고 위반0·모터쓰기0이었다. 기록상 full180s=false/all_pass=false이므로 전체 검증 통과로 표시하지 않는다. 최신 후속 노트3개는 [연구 노트 입구](https://www.notion.so/4065788b5ed1810aaec9c710b0d9e288)(접근 권한 필요)에서 연결한다.
+10/27의 새 IR2 정지 shadow는 양팔 각300 prefix를 30초 동안 확인했고 위반0·모터쓰기0이었다. 기록상 full180s=false/all_pass=false이므로 전체 검증 통과로 표시하지 않는다. 공개 가능한 조건과 후속 요약은 [CUSTOM ACT V1 실물 연동 기록](docs/CUSTOM_ACT_V1_KO.md#실물-연동과-후속-기록)에 모았다.
10/16 이후 상체 실행기는 이동 베이스를 직접 움직이지 않고 정지 요청을 전달한다. 모듈을 나눈 실행 구조는 본인의 Visual SLAM 직접 설계·구현 경험을 축소하는 의미가 아니다. 이동·도킹 공동 코드의 출처와 변경 이력도 유지한다.
@@ -76,4 +100,4 @@ PR 상태 확인일은 2026-10-08이다. 연구 PR을 닫은 것과 `main`에
외부 라이브러리와 자산은 각 폴더의 출처·라이선스를 따른다. Visual SLAM의 직접 설계·구현 경험과 공동 저장소의 외부·팀 기여 이력을 함께 보존한다.
-문서 갱신: 2026-10-27. 새 CUSTOM ACT V1의 수집·학습·SIM 평가·분석을 추가하고 기존 실물·코드·후보 PR 기록은 보존했다. 런타임·물리 파라미터·보정값·테스트·의존성은 변경하지 않았다.
+문서 구성 갱신: 2026-10-28. 실험 기록 기준: 2026-10-27. 새 CUSTOM ACT V1의 수집·학습·SIM 평가·분석을 추가하고 기존 실물·코드·후보 PR 기록은 보존했다. 런타임·물리 파라미터·보정값·테스트·의존성은 변경하지 않았다.
diff --git a/2ARM_ROBOT/docs/CUSTOM_ACT_V1_KO.md b/2ARM_ROBOT/docs/CUSTOM_ACT_V1_KO.md
index c94d6979..f8866250 100644
--- a/2ARM_ROBOT/docs/CUSTOM_ACT_V1_KO.md
+++ b/2ARM_ROBOT/docs/CUSTOM_ACT_V1_KO.md
@@ -4,7 +4,7 @@ SWEEPICK에서 학습 정책을 적용할 때, 낮은 예측 손실만으로는
**ACT는 팀원과 공동 개발·검증했다. 전형주 주 담당은 모방학습·시뮬레이션·Sim-to-Real·데이터 검증이며, Visual SLAM도 직접 설계·구현했다.** 아래 ACT 수치는 공동 실험 결과다. 개인 담당 경험과 연결해 설명하되, 외부 ACT·RoboTwin 구현과 팀 기여의 출처도 함께 남긴다.
-[프로젝트](../README.md) · [그림·영상으로 보기](https://julianjeonresume.netlify.app/research/custom-act-v1/) · [Notion 연구 노트](https://www.notion.so/4065788b5ed1810aaec9c710b0d9e288)(접근 권한 필요) · [이전 접촉·계획 연구](RESEARCH_SUMMARY_KO.md)
+[프로젝트](../README.md) · [그림·영상으로 보기](https://julianjeonresume.netlify.app/research/custom-act-v1/) · [공개 후속 요약](#실물-연동과-후속-기록)(접근 권한 필요) · [이전 접촉·계획 연구](RESEARCH_SUMMARY_KO.md)
## 1. 데이터 수집 — 동작을 보존하고 외형을 바꿨다
@@ -19,7 +19,7 @@ SWEEPICK에서 학습 정책을 적용할 때, 낮은 예측 손실만으로는
관절 상태·명령·시각·물체 pose와 head depth/PCD가 같은지 검사했다. 한 궤적의 외형 변형은 같은 분할에 묶어, 같은 동작이 학습과 평가에 나뉘어 들어가지 않게 했다. 정책 입력은 관절q·head PCD·양손목 RGB이며, 정답 행동·phase·물체 정답pose를 추론 입력에서 제외했다.
-
+
## 2. 학습 — 학습 곡선과 작업 완료를 따로 확인했다
@@ -32,7 +32,7 @@ shared wrist ResNet18+1×1 projection, hidden256, chunk20, state/action12, KL10,
최저 검증 손실은 epoch103에서 나왔다. 이200 epoch 실행의 최종·best 모델은 원본 묶음에서 폐루프 평가되지 않았다. 다음 절의 작업 완료율은 별도로 고정한 epoch30 체크포인트의 결과다.
-
+
## 3. 추론 — 고정한 모델로143개 위치를 실행했다
@@ -70,9 +70,7 @@ SWEEPICK의 물체 이동·청소·저전력 복귀·도킹·충전 흐름은
10/27 후속 노트는 ACT30과 실물 실행기의 관측·12축 절대행동 계약, 앙상블·STOP·feedback·파지 증거 경로를 정리한다. 저장 앙상블 비교와 코드 검사는 새 실물 파지 결과가 아니다. 새IR2는30초 정지 shadow, 양팔 각300 prefix, 위반0·모터쓰기0이며 full180s=false/all_pass=false다. 이전180초 G4 UNKNOWN 기록도 그대로 보존한다.
-- [SIM+실물 공동 학습·실행기 정합](https://www.notion.so/4065788b5ed1818f9df0dd925ddecff4)
-- [절대행동·STOP·feedback·파지 증거 경로](https://www.notion.so/4065788b5ed18153ba4cde8a49e0c1f1)
-- [IR2 정지 shadow 읽기 기록](https://www.notion.so/4065788b5ed181329e50ed6501a5942a)
+공개 후속 요약은 위 기록과 [프로젝트의 실물 트랙](../README.md#실물-데이터와-실행기-연동)에서 읽을 수 있다. 비공개 원본 노트의 주소·원시 로그·개인 장치 정보는 공개하지 않는다.
## 출처와 재검증 범위
@@ -87,3 +85,5 @@ SWEEPICK의 물체 이동·청소·저전력 복귀·도킹·충전 흐름은
공개 CSV·JSON은 평가 조건과 결과에 필요한 필드만 골랐다. 원시 데이터·학습 tensor·개인 장치 경로는 포함하지 않는다. 공식 ACT/RoboTwin 등 외부 구현의 출처·라이선스는 기존 코드와 원자료에 따른다. 이 문서는 담당 경험과 프로젝트 실험을 연결한 연구 요약이며 공동 데이터·외부 라이브러리 전체의 단독 저작을 주장하지 않는다.
갱신2026-10-27. 저장 기록을 재계산·대조했으며, 이 문서 작업 중 시뮬레이터나 실물 로봇을 새로 실행하지 않았다.
+
+문서 연결 정리: 2026-10-28. 위 실험 기록의 기준일과 결과는 유지했다.
diff --git a/2ARM_ROBOT/docs/README.md b/2ARM_ROBOT/docs/README.md
index f3c993a7..8a2ad887 100644
--- a/2ARM_ROBOT/docs/README.md
+++ b/2ARM_ROBOT/docs/README.md
@@ -1,10 +1,25 @@
-# 프로젝트 문서
+# SWEEPICK 문서 안내
-현재 실물 정본은 SO-101 양팔 + TurtleBot3 Waffle Pi + H201 top-view + 전면 Astra S + 좌우
-wrist RGB다. 장치명·역할·stable alias는 [`../config/hardware_roles.json`](../config/hardware_roles.json),
-현재 MuJoCo 실행은 [`../sim/mobile_dual_so101/README.md`](../sim/mobile_dual_so101/README.md)를
-우선한다. 제목에 JDcobot이 있거나 2026-08의 Astra Pro 단일 카메라를 전제로 한 문서는 초기
-연구·회귀 자료이며 현재 실물 명령 근거가 아니다.
+처음 읽는다면 최신 요약에서 시작한 뒤, 확인하려는 코드와 실험의 날짜로 내려간다. 아래 과거 문서는 당시 장비·소스 revision의 기록으로 보존한다.
+
+## 지금 읽을 문서
+
+| 질문 | 문서·근거 |
+|---|---|
+| 어떤 로봇이고 무엇을 담당했는가? | [SWEEPICK 개요·구성·기여](../README.md) |
+| 데이터를 어떻게 나누고 ACT를 평가했는가? | [CUSTOM ACT V1](CUSTOM_ACT_V1_KO.md) |
+| 실제 143개 위치 결과를 볼 수 있는가? | [위치별 CSV](evidence/custom_act_v1_20261027_positions.csv) · [조건·집계 JSON](evidence/custom_act_v1_20261027_summary.json) |
+| 모델·접촉·경로 검증은 어디에 있는가? | [이전 조작 연구와 고정 후보](RESEARCH_SUMMARY_KO.md) |
+| Python 연구와 C++ 실행 경계는 무엇인가? | [연구 계층](../research/README.md) · [제어 계약](../../contracts/README.md) |
+| 교육 코드부터 읽으려면? | [교육·실습 안내](../../docs/LEARNING_GUIDE_KO.md) |
+
+## 장비 구성과 날짜
+
+최근 조작 연구는 **SO-101 양팔·PGripper, 작업공간 OS30A RGB-D와 양손목 RGB**, 이동 베이스 전면 중앙의 **Astra RGB-D**를 구분한다. [프로젝트의 장비 설명](../README.md#장비-역할과-과거-설정)을 먼저 읽는다.
+
+[`hardware_roles.json`](../config/hardware_roles.json)의 `effective_date=2026-09-03`과 H201 top-view는 **당시 구성**이다. 이전 Astra Pro 단일 카메라, JDcobot, 박스·신발 과제 문서도 현재 설정으로 바꿔 읽지 않는다. 문서를 최신화했다고 런타임·보정값이 갱신된 것은 아니다.
+
+## 이전 설계·실습·연구 기록
- [`requirements-ledger.md`](requirements-ledger.md): 현재 확정·미확정 요구사항 원장
- [`PHASE0_HANDOFF.md`](PHASE0_HANDOFF.md): Ubuntu ROS 2 PC 개발 인수인계
@@ -34,5 +49,5 @@ wrist RGB다. 장치명·역할·stable alias는 [`../config/hardware_roles.json
- [`2026-09-04-depth-box-pregrasp.md`](2026-09-04-depth-box-pregrasp.md): H201 depth 박스 pose, 앞날개 오른팔 IK·손목 RGB 보정, teleop→ACT episode 검증 기록
- [`research/MOBILE_DUAL_SO101_EXECUTION_LEDGER_20260902.md`](research/MOBILE_DUAL_SO101_EXECUTION_LEDGER_20260902.md): PR #40을 고정한 뒤 별도 브랜치에서 진행하는 양팔 박스·신발 미션의 단계별 구현·검증·학습 원장
-팀의 현재 결정은 `ACT baseline + DYNA-lite + 4주차 이후 보조학습
+아래 문서 작성 당시의 팀 결정은 `ACT baseline + DYNA-lite + 4주차 이후 보조학습
go/no-go`다. 조사 참고자료의 전체 SLIM/DYNA 구성을 무조건 적용하지 않는다.
diff --git a/2ARM_ROBOT/research/README.md b/2ARM_ROBOT/research/README.md
index 2acb8b9a..f3700911 100644
--- a/2ARM_ROBOT/research/README.md
+++ b/2ARM_ROBOT/research/README.md
@@ -21,6 +21,18 @@ sequence, TTL, limit, interlock과 실행 허가를 다시 검사한다.
남긴 `source_monotonic_ns`는 trace용이고, C++ 수신기가 자신의 monotonic clock으로
`ttl_ns`를 시작한다.
+## 읽는 순서
+
+| 순서 | 코드 | 확인할 내용 |
+|---|---|---|
+| 1 | [관측 출처](src/dapier_research/observation_contract.py) | 실제 센서 관측과 시뮬레이터 정답을 구분하는 경계 |
+| 2 | [깊이 기반 목표](src/dapier_research/vision_target.py) | 깊이·카메라 내부 파라미터·좌표 변환으로 목표 계산 |
+| 3 | [제어 제안](src/dapier_research/control_intent.py) | 관절 명령의 형태·시간·단위와 실행 권한 구분 |
+| 4 | [지역화 replay](src/dapier_research/localization_replay.py) | 누락·지연·재지역화 때 멈춤과 재계획 판단 |
+| 5 | [테스트](test/) | 장비 없는 입력·실패 조건 검사 |
+
+[SWEEPICK 전체 구성](../README.md) · [CUSTOM ACT V1 결과](../docs/CUSTOM_ACT_V1_KO.md) · [교육·실습 안내](../../docs/LEARNING_GUIDE_KO.md)
+
## RGB-D target geometry
[`vision_target.py`](src/dapier_research/vision_target.py)는 detector mask와 aligned
diff --git a/README.md b/README.md
index 09311ba4..72ab9622 100644
--- a/README.md
+++ b/README.md
@@ -1,58 +1,62 @@
-# DAPIER | 전형주 · Physical AI와 로봇 소프트웨어
+# DAPIER · Physical AI와 로봇 소프트웨어
-DAPIER에서 배운 내용을 로봇 연동, 시뮬레이션과 데이터 검증으로 확인하는 포트폴리오 저장소다. 관측을 학습 데이터로 만들고, 학습 정책의 출력이 실제 로봇 명령으로 이어지는 과정을 중심으로 정리했다.
+동국대학교 DAPIER 1기에서 배운 내용을 로봇 연동·시뮬레이션·학습 데이터 검증으로 확인하며 기록하고 있다. 대표 팀 프로젝트 **SWEEPICK**에서는 청소 경로의 작은 물체를 옮기는 양팔 모바일 매니퓰레이터를 만든다.
-대표 팀 프로젝트 **SWEEPICK**은 청소 경로의 작은 물체를 옮겨 공간을 확보하는 저비용 양팔 모바일 매니퓰레이터다. 물체 이동·청소·저전력 복귀·도킹·충전 흐름은 시뮬레이션에서 구현했고, 실물 기능을 통합하고 있다. 초기 신발 정리 과제는 개발 이력으로 보존한다.
+
-**ACT는 팀원과 공동 개발·검증했다. 전형주 주 담당은 모방학습·시뮬레이션·Sim-to-Real·데이터 검증이며, Visual SLAM도 직접 설계·구현했다.** 아래 ACT 수치는 공동 실험 결과다. 개인 담당 경험과 연결해 설명하되, 외부 ACT·RoboTwin 구현과 팀 기여의 출처도 함께 남긴다.
+CUSTOM ACT V1 대표 SIM 실행 · 고정 epoch30 · temporal ensemble ON · Test mid00_01 한 위치의 기록 · [원본 MP4](https://julianjeonresume.netlify.app/assets/custom-act-v1/sim-test-mid00_01.mp4) · [평가 조건과 143회 결과](2ARM_ROBOT/docs/CUSTOM_ACT_V1_KO.md) · [영상 출처](docs/media/README.md)
-[포트폴리오·이력서](https://julianjeonresume.netlify.app/) · [SWEEPICK 프로젝트](2ARM_ROBOT/README.md) · [CUSTOM ACT V1 실험 기록](2ARM_ROBOT/docs/CUSTOM_ACT_V1_KO.md) · [공개 그림·영상](https://julianjeonresume.netlify.app/research/custom-act-v1/) · [이전 조작 연구](2ARM_ROBOT/docs/RESEARCH_SUMMARY_KO.md)
+**[SWEEPICK 프로젝트](2ARM_ROBOT/README.md)** · **[교육·실습 안내](docs/LEARNING_GUIDE_KO.md)** · **[포트폴리오·이력서](https://julianjeonresume.netlify.app/)**
-## CUSTOM ACT V1: 데이터에서 실행까지
+## 무엇을 했는가
-학습 손실만으로 로봇의 작업 완료를 판단하기 어려웠다. 시연을 어떤 기준으로 나누었는지, 정책이 어떤 관측을 받는지, 예측한 행동 청크가 실제 명령으로 어떻게 이어지는지를 함께 기록했다.
+ACT는 팀원과 **공동 개발·검증**했다. 나의 주 담당은 **모방학습·시뮬레이션·Sim-to-Real·데이터 검증**이며, **Visual SLAM도 직접 설계·구현**했다. 외부 교육 코드와 라이브러리는 원본 출처 및 변경 이력과 함께 읽는다.
-| 단계 | 수행 내용 | 확인한 결과 |
+| 분야 | 사용 기술 | 코드·기록 |
|---|---|---|
-| 데이터 수집 | 원본 113개 궤적의 동작을 유지하며 손목 RGB의 물체색·배경·테이블 텍스처·조명을 5개 외형으로 구성. 관측·상태·명령·시각 정합 확인 | 565개 뷰. 궤적 train/val/test=59/29/25, 뷰=295/145/125. 같은 궤적의 외형은 동일 분할 유지 |
-| 학습 | 양손목 RGB·head PCD·관절 상태를 입력으로 사용하는 ACT 학습 | 200 epoch 완료. best validation은 epoch103, prior normalized L1=0.01553 |
-| 추론 | 별도로 고정한 epoch30 체크포인트, temporal ensemble ON(k=0.01)으로 SIM 폐루프 평가 | 143개 위치 각 1회 중 132회 완료(92.3%). Test 위치는 27/31(87.1%) |
-| 분석 | 예측 청크의 target 시점·가중치·관절 명령·실측값·phase·영상 연결 | 실패 11회 중 grasp/lift 7회, stow 4회. 청크 집계 결과를 저장 CSV에서 재구성해 확인 |
+| 언어·개발 환경 | Python · C++ · Linux(Ubuntu) · Git | [Python 연구 계층](2ARM_ROBOT/research/README.md) · [C++ 관절 코어](so101_ros2/dapier_so101_core/src/joint_model.cpp) |
+| 로봇·비전 | ROS 2 · TF · URDF/RViz · OpenCV · RGB-D | [ROS 2 스택](so101_ros2/README.md) · [Visual SLAM·이동 모듈](https://github.com/shouttt1320/Dapier_project_visaul_slam) |
+| 학습·시뮬레이션 | PyTorch · LeRobot/ACT · MuJoCo · RoboTwin | [CUSTOM ACT V1](2ARM_ROBOT/docs/CUSTOM_ACT_V1_KO.md) · [교육 코드](so101_imitation_learning/README.md) |
+| 장치 연동·데이터 | SO-101/STS3215 · Serial · 관절 tick↔rad · state/action 검증 | [상태 조회 기록](2ARM_ROBOT/docs/evidence/dual_arm_read_only_summary_20260820.json) · [관측 출처 계약](2ARM_ROBOT/research/OBSERVATION_PROVENANCE.md) |
-폐루프 완료 기준은 **30 mm 이상 Lift → Stow → 물리 2초 Hold**다. 외형은 랜덤화하고 물체 크기(40 mm)·yaw·물성·카메라 보정은 고정했다. 위 92.3%는 이 SIM 조작 평가의 관측값이다. 200 epoch 최종 모델의 폐루프 결과, 실물 성공률이나 전체 청소 시나리오 성공률과 합산하지 않는다.
+## 핵심 결과
-## 실물 기록과 후속 연동
-
-기존 실물 트랙은 신규 SIM 평가와 별도로 유지한다. 2026-10-18~26 Native 교사 콘솔은 집기·이동·놓기·복귀 120/198회를 성공으로 판정했다. 실물 데이터 기반 ACT TJJ v2는 학습46/검증7 run의 관절 예측오차 3.30°(epoch690)를 기록했고, 정책 정체 후 교사 인계로 교정 시연16개를 확보했다. 예측오차는 작업 완료율과 다른 지표다.
+| 확인한 내용 | 결과와 조건 | 근거 |
+|---|---|---|
+| 데이터 구성 | 원본 113궤적 × 외형 5종 = 565뷰. 같은 궤적의 외형은 같은 train/val/test 분할에 유지 | [데이터·분할](2ARM_ROBOT/docs/CUSTOM_ACT_V1_KO.md#1-데이터-수집--동작을-보존하고-외형을-바꿨다) |
+| ACT 학습 | 200 epoch 완료. best validation은 epoch103, prior normalized L1 0.01553 | [학습 조건·곡선](2ARM_ROBOT/docs/CUSTOM_ACT_V1_KO.md#2-학습--학습-곡선과-작업-완료를-따로-확인했다) |
+| 고정 모델 SIM 평가 | 별도로 고정한 epoch30으로 143개 위치 각 1회 중 **132/143, 92.3%** 완료. Test 위치 **27/31, 87.1%** | [위치별 CSV](2ARM_ROBOT/docs/evidence/custom_act_v1_20261027_positions.csv) · [조건·집계 JSON](2ARM_ROBOT/docs/evidence/custom_act_v1_20261027_summary.json) |
+| 실패 분석 | 완료하지 못한 11회는 grasp/lift 7회, stow 4회. 예측 청크·관절 명령·실측값·영상을 대조 | [추론 실행 분석](2ARM_ROBOT/docs/CUSTOM_ACT_V1_KO.md#4-분석--예측-청크가-명령이-되는-과정을-추적했다) |
+| 실물 연동 | Native 교사 120/198회, 실물 데이터 ACT TJJ v2 관절 예측오차 3.30°, DAgger 교정 시연 16개를 별도 기록. 10/27에는 모터 명령 없는 정지 shadow 확인 | [실물 트랙과 후속 연동](2ARM_ROBOT/README.md#실물-데이터와-실행기-연동) |
-10/27 후속 연구는 ACT30과 실물 실행기의 관측·12축 절대행동 계약, 앙상블·STOP·feedback·파지 증거의 연결을 확인하는 단계다. 새 30초 정지 shadow는 모터 명령 없이 읽기 경로를 확인한 기록이며, 전체 180초 검증과 새 실물 파지 완료를 뜻하지 않는다. [최신 연구 노트](https://www.notion.so/4065788b5ed1810aaec9c710b0d9e288)(접근 권한 필요)에 조건과 후속 기록을 연결했다.
+SIM 완료 기준은 **30 mm 이상 Lift → Stow → 물리 2초 Hold**다. 외형은 랜덤화하고 물체 크기 40 mm·yaw·물성·카메라 보정은 고정했다. 위 평가 모델은 200 epoch 최종 모델과 구분한다. 물체 이동·청소·저전력 복귀·도킹·충전 전체 흐름은 시뮬레이션에서 구현했고, 현재 실물 기능을 통합하고 있다.
-## 코드와 연구 이력
+## 프로젝트와 교육 코드를 찾는 순서
-| 확인할 내용 | 코드와 문서 |
+| 보고 싶은 내용 | 시작점 |
|---|---|
-| 수집·학습·추론·분석의 조건과 근거 | [CUSTOM ACT V1](2ARM_ROBOT/docs/CUSTOM_ACT_V1_KO.md) |
-| 실물 실행기·콘솔·저장 기록 검수 | [sweepick 검토 브랜치](https://github.com/Alpenj/DAPIER/tree/pro/sweepick-review-20261015/2ARM_ROBOT/sweepick) |
-| 양팔 모델·접촉·경로 검사 | [MuJoCo 모델](2ARM_ROBOT/sim/mobile_dual_so101/README.md) · [이전 연구](2ARM_ROBOT/docs/RESEARCH_SUMMARY_KO.md) |
-| Visual SLAM·Nav2·도킹 모듈 | [이동 모듈 협업 저장소](https://github.com/shouttt1320/Dapier_project_visaul_slam) |
+| 로봇 구성, 구현 범위, 실행기와 연구 결과 | [SWEEPICK](2ARM_ROBOT/README.md) |
+| 수집 → 학습 → 추론 → 분석의 조건과 근거 | [CUSTOM ACT V1 연구 기록](2ARM_ROBOT/docs/CUSTOM_ACT_V1_KO.md) |
+| RGB-D·관절 데이터 계약, 정책 제안과 C++ 실행 경계 | [Python 연구 계층](2ARM_ROBOT/research/README.md) · [제어 계약](contracts/README.md) |
+| 강의에서 배운 기술과 프로젝트 적용의 연결 | [DAPIER 교육·실습 안내](docs/LEARNING_GUIDE_KO.md) |
+| 예전 장비·실험·실패·후보 브랜치 | [프로젝트 문서 목록](2ARM_ROBOT/docs/README.md) · [이전 조작 연구](2ARM_ROBOT/docs/RESEARCH_SUMMARY_KO.md) |
-상체 실행기는 10/16부터 이동 베이스를 직접 구동하지 않고 정지 요청과 조작 결과를 전달하는 역할로 나눴다. 이 실행 구조와 본인의 Visual SLAM 설계·구현 경험은 별개다. 공동 저장소와 교육 예제·외부 라이브러리의 기여 이력은 보존한다.
+## 장비 없이 먼저 확인하기
-연구 실행기와 후속 결과가 모두 공개 `main`에 병합된 것은 아니다. 검토 브랜치 및 고정 후보의 결과는 해당 revision에서 읽는다. 이번 갱신은 문서와 공개 요약 근거를 정리한 것으로, 런타임·보정값·장치 설정을 변경하지 않았다.
+Python 3.12 환경에서 저장소 루트의 연구 계층 테스트를 실행할 수 있다. 관측 출처, 명령 형태·TTL, 지역화 상태와 깊이 기반 좌표 변환을 확인하며 장치를 열지 않는다.
-## 교육·실습 코드
+```bash
+git clone https://github.com/Alpenj/DAPIER.git
+cd DAPIER
+python3 -m unittest discover -s 2ARM_ROBOT/research/test -v
+```
-| 폴더 | 내용 |
-|---|---|
-| [so101](so101/README.md) · [so101_ros2](so101_ros2/README.md) | SO-101 실습, LeRobot 연동, ROS 2 제어 |
-| [so101_imitation_learning](so101_imitation_learning/) | PyTorch·모방학습 교육 코드 |
-| [deepThinkCar_mini](deepThinkCar_mini/) | 자율주행 자동차 실습 |
-| [turtlebot3_ws](turtlebot3_ws/README.md) · [ros_dd_ws](ros_dd_ws/README.md) | 이동로봇 시뮬레이션, SLAM·내비게이션 학습 |
-| [jdcobot100_sim](jdcobot100_sim/README.md) · [ros_arm](ros_arm/README.md) | 로봇암 시뮬레이션과 Arduino 제어 |
-| [dapier_sim_first](dapier_sim_first/README.md) · [casino_dealer](casino_dealer/README.md) | 한 팔 조작과 카드 딜러 실험 |
+2026-10-28에 기존 소스 그대로 Windows·Python 3.12에서 33개 테스트를 확인했다. ROS 2·MuJoCo 실행은 [연구 계층](2ARM_ROBOT/research/README.md)과 각 모듈의 환경 안내를 따른다. 실물 보정·제어는 [하드웨어 안전 절차](docs/HARDWARE_SAFETY_KO.md)를 먼저 확인한다.
-실행 환경은 각 폴더의 README를 확인한다. 오래된 실습의 장비 구성·파라미터는 해당 날짜의 조건이며, 현재 장비에 그대로 적용하지 않는다. 실물 접근·제어는 [하드웨어 안전 절차](docs/HARDWARE_SAFETY_KO.md)를 따른다.
+## 기록을 읽을 때
-외부 코드·자산의 출처와 라이선스는 해당 폴더에 보존했다. 별도 학습 포크를 이 저장소로 옮긴 내역은 [통합 기록](docs/FORK_MIGRATION_20260907_KO.md)에서 확인할 수 있다.
+- **SIM / MOCK / HW**를 구분한다. 테스트 통과, 예측오차와 실제 작업 완료는 서로 다른 결과다.
+- 공개 `main`과 고정 후보·검토 브랜치의 구현 범위가 다르다. 결과에 연결한 revision과 실행 조건을 함께 확인한다.
+- 교육 예제·외부 코드·자산의 출처는 각 폴더에 보존한다. 이전 학습 포크를 옮긴 내역은 [통합 기록](docs/FORK_MIGRATION_20260907_KO.md)에 있다.
-문서 갱신: 2026-10-27. 지정된 CUSTOM ACT V1 내장 보고서·CSV·학습 로그와 기존 Notion·실물 기록을 대조했다.
+DAPIER 교육: **2026.07.06–11.04 · 수강 중 · 총 편성 656시간**. 문서 정리 기준일: 2026-10-28.
diff --git a/deepThinkCar_mini/README.md b/deepThinkCar_mini/README.md
index 56d0b09c..b7eaca2e 100644
--- a/deepThinkCar_mini/README.md
+++ b/deepThinkCar_mini/README.md
@@ -1,5 +1,13 @@
# deepThinkCar-mini | 비전·모방학습 주행 실습
+영상 수집·라벨·PC 학습·차량 추론의 흐름을 살펴보는 교육 자료다. 아래 원본 기능 설명과 실제로 수행한 개인 실험을 구분한다.
+
+[영상 수집](jd_1_record_lane_video.py) · [학습 데이터](jd_2_get_train_data.py) · [PC 코드](PC_run_code/)
+
+[교육 전체 안내](../docs/LEARNING_GUIDE_KO.md) · [최신 SWEEPICK](../2ARM_ROBOT/README.md) · [저장소 첫 화면](../README.md)
+
+## 기록의 범위와 기존 실행 안내
+
**카메라 영상 → OpenCV 차선 인식 → 데이터 라벨링 → PC 학습 → 차량 추론**의 연결을 배우는 Raspberry Pi 기반 교육용 저장소입니다.
[전형주 포트폴리오](https://julianjeonresume.netlify.app/) · [개인 학습 아카이브](https://github.com/Alpenj/physical-ai-lab) · [변경 이력](https://github.com/Alpenj/deepThinkCar_mini/commits/main/)
diff --git a/docs/LEARNING_GUIDE_KO.md b/docs/LEARNING_GUIDE_KO.md
new file mode 100644
index 00000000..ead3d29c
--- /dev/null
+++ b/docs/LEARNING_GUIDE_KO.md
@@ -0,0 +1,43 @@
+# DAPIER 교육·실습 안내
+
+동국대학교 DAPIER 1기 Physical AI 과정에서 언어·제어 기초를 익히고, 카메라와 로봇의 상태를 학습·실행 데이터로 연결하는 방법을 공부하고 있다. 교육 기간은 **2026.07.06–11.04**, 현재 수강 중이며 총 편성은 **656시간**이다.
+
+예제 코드를 읽거나 수정한 경험, SIM/MOCK에서 확인한 결과, 실물 장치에서 확인한 기록을 나눠 정리했다. 원본 교육 코드의 기능과 개인 구현 성과도 구분한다.
+
+## 읽는 순서
+
+| 단계 | 배운 내용 | 시작할 코드·문서 | 프로젝트와의 연결 |
+|---|---|---|---|
+| 1. 언어와 장치 | Python·C++·Linux, Arduino Serial/UART·PWM 코드 실습 | [4축 로봇암](../ros_arm/README.md) · [시리얼 브리지](../ros_arm/ros_arm/ros_arm_bridge.py) · [Arduino 코드](../ros_arm/arduino/ros_control/ros_control.ino) | 관절 이름·rad/degree·명령 문자열의 관계를 읽는다 |
+| 2. 모델과 ROS 2 | URDF·TF·RViz, 노드·토픽·launch | [JDcobot 시뮬레이션](../jdcobot100_sim/README.md) · [SO-101 ROS 2](../so101_ros2/README.md) | C++ 관절 변환·한계와 Python 연구 제안을 구분한다 |
+| 3. 이동과 좌표계 | Gazebo Harmonic, SLAM·Nav2·AMCL·프레임 | [TurtleBot3](../turtlebot3_ws/README.md) · [차동구동 로봇](../ros_dd_ws/README.md) | Jazzy 환경 이식, 지도·localization·이동 모듈 이해 |
+| 4. 영상과 학습 데이터 | OpenCV·카메라 영상·조향 라벨·PC 학습 | [deepThinkCar-mini](../deepThinkCar_mini/README.md) | 수집·학습·검증 데이터와 실제 동작 결과를 구분한다 |
+| 5. 정책 학습 | PyTorch·Transformer·ACT·추론 청크 | [모방학습 교육 코드](../so101_imitation_learning/README.md) · [ACT 단계별 예제](../so101_imitation_learning/103_ACT_step_by_step/) | ACT 공동 학습에서 입력·출력·청크 실행을 비교한다 |
+| 6. 시뮬레이션과 연동 | MuJoCo·SO-101, 데이터·접촉 조건 | [한 팔 실험 이력](../so101/README.md) · [SWEEPICK 모델](../2ARM_ROBOT/sim/mobile_dual_so101/README.md) | 관측·state/action·단위·시각과 실제 장치 조건 대조 |
+
+표는 학습 흐름이며 모든 폴더를 순서대로 설치해야 한다는 뜻은 아니다. 각 모듈의 환경이 다르므로 읽으려는 폴더의 README에서 버전과 실행 범위를 확인한다.
+
+## 교육에서 SWEEPICK으로
+
+- Arduino Serial/UART 송수신·PWM 제어는 **교육 코드 실습**으로 적었다. SO-101/STS3215 상태 조회는 [저장된 read-only 기록](../2ARM_ROBOT/docs/evidence/dual_arm_read_only_summary_20260820.json)과 함께 확인한다.
+- [C++ 관절 코어](../so101_ros2/dapier_so101_core/src/joint_model.cpp)에서 변환·한계를 다루고, [Python 연구 계층](../2ARM_ROBOT/research/README.md)에서는 관측 출처·데이터·정책 제안을 다룬다. 이 스택의 미구현 하드웨어 드라이버를 실물 완료로 소개하지 않는다.
+- ACT는 팀원과 공동 개발·검증했다. 나는 모방학습·시뮬레이션·Sim-to-Real·데이터 검증을 주로 담당했고, Visual SLAM도 직접 설계·구현했다. [CUSTOM ACT V1](../2ARM_ROBOT/docs/CUSTOM_ACT_V1_KO.md)에서 학습 조건과 SIM 평가를 읽을 수 있다.
+- Isaac Sim은 환경·장면·센서 기초를 학습한 범위다. 여기서 근거로 연결하는 MuJoCo·RoboTwin 프로젝트 실행과 구분한다.
+
+## 다른 실험과 원본 자료
+
+| 폴더 | 범위 |
+|---|---|
+| [dapier_sim_first](../dapier_sim_first/README.md) | 한 팔 SIM의 관측·접촉·성공 판정과 실패 조사 |
+| [casino_dealer](../casino_dealer/README.md) | 카드 딜러의 초기 기구학·계획 실험 |
+| [onshape/jdcobot100](../onshape/jdcobot100/README.md) | 로봇암 형상과 모델 변환 자료 |
+| [puppy MuJoCo](../puppy/mujoco/README.md) | 별도 MuJoCo 학습 자료 |
+| [학습 포크 통합 기록](FORK_MIGRATION_20260907_KO.md) | 교육용 원본과 DAPIER로 옮긴 경위 |
+
+## 실행 전에
+
+코드 탐색은 GitHub에서 할 수 있다. 장비 없이 연구 계층을 확인하려면 [저장소 첫 화면의 Python 테스트](../README.md#장비-없이-먼저-확인하기)를 따른다. ROS 2·Gazebo·MuJoCo의 설치·실행은 각 README의 환경을 사용한다.
+
+과거 문서의 장치 이름·보정값·성능은 그 시점의 기록이다. 실제 로봇 접속·보정·제어는 [하드웨어 안전 절차](HARDWARE_SAFETY_KO.md)에 따라 현장에서 확인한다. 공개 저장소에는 녹음·원시 개인 데이터·장치 식별자·개인 보정 파일을 싣지 않는다.
+
+정리 기준일: 2026-10-28. 기존 교육·실험 기록과 공개 코드를 대조한 안내이며 수료 또는 새 실물 실행 결과를 추가한 것은 아니다.
diff --git a/docs/media/README.md b/docs/media/README.md
new file mode 100644
index 00000000..78258b9e
--- /dev/null
+++ b/docs/media/README.md
@@ -0,0 +1,17 @@
+# 공개 그림·영상 출처
+
+이 폴더는 기존 CUSTOM ACT V1 공개 연구 페이지의 그림·영상으로 구성했다. 새 로봇 실험이나 AI 생성 장면을 만들지 않았다.
+
+| 파일 | 출처와 의미 |
+|---|---|
+| [custom-act-sim.gif](custom-act-sim.gif) | 고정 epoch30·temporal ensemble ON, Test mid00_01 한 위치의 기존 SIM 영상. 장면과 손목 RGB를 함께 표시한다. 원본 MP4 전체 7.2초를 너비640·8fps GIF로 변환했다. |
+| [collection-appearances.png](collection-appearances.png) | 같은 궤적에 적용한 외형 구성. 신규 물리 동작이나 독립 궤적 수로 세지 않는다. |
+| [training-curves.png](training-curves.png) | 200epoch 학습 곡선. 고정epoch30 폐루프 평가와 구분한다. |
+
+[원래 연구 페이지](https://julianjeonresume.netlify.app/research/custom-act-v1/) · [원본 MP4](https://julianjeonresume.netlify.app/assets/custom-act-v1/sim-test-mid00_01.mp4) · [평가 조건·기여도](../../2ARM_ROBOT/docs/CUSTOM_ACT_V1_KO.md)
+
+ACT 공동 실험의 기록이며 단독 저작이나 실물 시연으로 소개하지 않는다. 원본 HTML·체크포인트 식별자는 연구 문서에, 이 미디어의 원본 해시는 [출처 명세](sources.json)에 보존했다.
+
+## 시스템 구성도
+
+[SWEEPICK 구성도](sweepick-system.png)는 프로젝트 README의 관측·학습·실행 구조를 정리한 설명 그림이다. 실험 캡처나 성능 증거를 대신하지 않는다. [Mermaid 원본](sweepick-system.mmd)을 함께 보관한다. GitHub에서 외부 다이어그램 렌더러가 표시 오류를 보여 동일 구조를 PNG로 제공한다.
diff --git a/docs/media/collection-appearances.png b/docs/media/collection-appearances.png
new file mode 100644
index 00000000..0e30cccc
Binary files /dev/null and b/docs/media/collection-appearances.png differ
diff --git a/docs/media/custom-act-sim.gif b/docs/media/custom-act-sim.gif
new file mode 100644
index 00000000..bef31793
Binary files /dev/null and b/docs/media/custom-act-sim.gif differ
diff --git a/docs/media/sources.json b/docs/media/sources.json
new file mode 100644
index 00000000..4e1b3cbb
--- /dev/null
+++ b/docs/media/sources.json
@@ -0,0 +1,32 @@
+{
+ "source_as_of": "2026-10-27",
+ "documentation_date": "2026-10-28",
+ "sources": [
+ {
+ "source": "https://julianjeonresume.netlify.app/assets/custom-act-v1/sim-test-mid00_01.mp4",
+ "sha256": "caa1a9c6eadf6f4419398ec0574498e2f7ae6f3905807a194ae4e972078ceec2",
+ "role": "Existing published CUSTOM ACT V1 evaluation media"
+ },
+ {
+ "source": "https://julianjeonresume.netlify.app/assets/custom-act-v1/collection-appearances.png",
+ "sha256": "2f204eec5b9593cfa32c46d34c04864a53f41f6b58c55704de5b2929ea327390",
+ "role": "Existing published CUSTOM ACT V1 evaluation media"
+ },
+ {
+ "source": "https://julianjeonresume.netlify.app/assets/custom-act-v1/training-curves.png",
+ "sha256": "ab86e85ae2f69211c6a9859cd55f6213dffd214fc551f3a0911fcb3af15d5d18",
+ "role": "Existing published CUSTOM ACT V1 evaluation media"
+ }
+ ],
+ "gif": {
+ "file": "custom-act-sim.gif",
+ "sha256": "824bdb4ffb99713a1b03b21a16ed11f0f6e871ece66a47fba8b1ad4001d11e96",
+ "conversion": "ffmpeg: fps=8, scale=640:-1, palettegen max_colors=128, paletteuse bayer; full source duration"
+ },
+ "system_diagram": {
+ "file": "sweepick-system.png",
+ "sha256": "04fd7c5e8a440a5e9d050907b37a6e1c89c407461fc878e99052e97ccf3ab385",
+ "source": "sweepick-system.mmd",
+ "role": "Explanatory system diagram; not experiment evidence"
+ }
+}
diff --git a/docs/media/sweepick-system.mmd b/docs/media/sweepick-system.mmd
new file mode 100644
index 00000000..37e91435
--- /dev/null
+++ b/docs/media/sweepick-system.mmd
@@ -0,0 +1,11 @@
+flowchart LR
+ S["RGB-D·손목 RGB·관절 상태"] --> D["수집·시각·단위·분할 검증"]
+ D --> T["ACT 공동 학습"]
+ S --> P["ACT 추론·청크 집계"]
+ T --> P
+ P --> A["관절 명령·정지 조건"]
+ A --> M["SIM 실행"]
+ A --> H["실물 연동·통합 중
별도 실행기"]
+ M --> E["Lift·Stow·Hold 평가"]
+ H --> L["실측·영상·명령 기록"]
+ L --> D
diff --git a/docs/media/sweepick-system.png b/docs/media/sweepick-system.png
new file mode 100644
index 00000000..befdc342
Binary files /dev/null and b/docs/media/sweepick-system.png differ
diff --git a/docs/media/training-curves.png b/docs/media/training-curves.png
new file mode 100644
index 00000000..0313f45b
Binary files /dev/null and b/docs/media/training-curves.png differ
diff --git a/jdcobot100_sim/README.md b/jdcobot100_sim/README.md
index 81393c8f..2389ca1d 100644
--- a/jdcobot100_sim/README.md
+++ b/jdcobot100_sim/README.md
@@ -1,5 +1,13 @@
# jdcobot100_sim
+실제 장비 연결에 앞서 관절 이름·모델·컨트롤러와 launch 흐름을 확인하는 시뮬레이션 전용 패키지다.
+
+[RViz launch](launch/rviz.launch.py) · [Gazebo launch](launch/gazebo.launch.py) · [컨트롤러 설정](config/gazebo_controllers.yaml)
+
+[교육 전체 안내](../docs/LEARNING_GUIDE_KO.md) · [최신 SWEEPICK](../2ARM_ROBOT/README.md) · [저장소 첫 화면](../README.md)
+
+## 기록의 범위와 기존 실행 안내
+
이 패키지는 제가 실제 부품을 연결하기 전에 RViz·Gazebo에서 관절 이름,
launch 순서, controller 연결을 확인하기 위해 사용하는 시뮬레이션 공간입니다.
여기서 보이는 움직임을 실제 서보가 움직였다고 해석하지 않습니다.
diff --git a/ros_arm/README.md b/ros_arm/README.md
index 2b87b98e..0abba6a9 100644
--- a/ros_arm/README.md
+++ b/ros_arm/README.md
@@ -1,7 +1,15 @@
# ROS 2 + Arduino 4축 로봇암
+ROS 2 JointState의 관절 이름·rad를 Arduino 시리얼 명령과 servo degree로 잇는 4축 교육 프로젝트다. 아래 배선·펌웨어·제어 설명은 이 장비의 학습 기록이다.
+
+[ROS 시리얼 브리지](ros_arm/ros_arm_bridge.py) · [Arduino 코드](arduino/ros_control/ros_control.ino) · [시퀀스 GUI](ros_arm/sequence_gui.py)
+
+[교육 전체 안내](../docs/LEARNING_GUIDE_KO.md) · [최신 SWEEPICK](../2ARM_ROBOT/README.md) · [저장소 첫 화면](../README.md)
+
+## 기록의 범위와 기존 실행 안내
+
이 폴더는 제가 ROS 2와 서보 제어의 기본 흐름을 익히며 만든 4축 실험
-패키지입니다. 현재 SO-101 카지노 딜러 방향과는 다른 하드웨어이므로,
+패키지입니다. 이후의 SO-101·SWEEPICK과는 다른 하드웨어이므로,
여기서 확인한 GUI·토픽·시리얼 개념을 그대로 SO-101 실물 결과라고
간주하지 않습니다.
diff --git a/ros_dd_ws/README.md b/ros_dd_ws/README.md
index 660755b6..b0df6cb9 100644
--- a/ros_dd_ws/README.md
+++ b/ros_dd_ws/README.md
@@ -1,5 +1,13 @@
# ros_dd_ws — 패키지 구조 및 가상 물리 환경 (ROS2 Jazzy)
+차동구동 로봇의 URDF·물리 장면·TF·SLAM·Nav2를 한 흐름으로 확인한 Jazzy 워크스페이스다. 아래 날짜별 설명과 오류 기록을 보존한다.
+
+[로봇 모델](src/ros_dd_description/) · [시뮬레이션](src/ros_dd_gazebo/) · [내비게이션](src/ros_dd_navigation/)
+
+[교육 전체 안내](../docs/LEARNING_GUIDE_KO.md) · [최신 SWEEPICK](../2ARM_ROBOT/README.md) · [저장소 첫 화면](../README.md)
+
+## 기록의 범위와 기존 실행 안내
+
`ros_dd_*` 커스텀 차동구동(differential-drive) 로봇 워크스페이스. `turtlebot3_ws`와
마찬가지로 이 PC는 **ROS2 Jazzy + gz-sim(Harmonic)**만 설치돼 있어, 원본 교재가
전제하는 Gazebo Classic 파이프라인(`gazebo_ros`, `gzserver`/`gzclient`,
diff --git a/so101/README.md b/so101/README.md
index 9fe93aa3..99ff0162 100644
--- a/so101/README.md
+++ b/so101/README.md
@@ -1,16 +1,24 @@
# SO-101 작업 허브
+SO-101의 한 팔 학습·접촉 모델·장치 연결을 조사한 초기 작업 기록이다. 최신 양팔 프로젝트의 결과는 별도 SWEEPICK 문서에서 읽는다.
+
+[실험 기록](records/) · [하드웨어 도구](hardware_tools/README.md) · [한 팔 SIM](../dapier_sim_first/README.md)
+
+[교육 전체 안내](../docs/LEARNING_GUIDE_KO.md) · [최신 SWEEPICK](../2ARM_ROBOT/README.md) · [저장소 첫 화면](../README.md)
+
+## 기록의 범위와 기존 실행 안내
+
이 페이지는 SO-101 관련 코드와 실험 기록이 어디에 있는지 찾기 위한 인덱스다.
세부 실행 로그와 수치는 `records/`에 그대로 두고, 여기에는 지금 유효한 판단과
읽는 순서만 정리한다.
-최종 목표는 한 팔 카드 pick/place를 안정화한 뒤 두 번째 팔을 추가하는 것이다.
+이 초기 실험의 목표는 한 팔 카드 pick/place를 안정화한 뒤 두 번째 팔을 추가하는 것이었다.
현재 저장소에 있는 SO-101 결과는 아직 **단일 팔·단일 cube task**가 중심이며,
카지노 카드나 양팔 데이터로 해석하지 않는다.
## 현재 판단
-저장소에 남아 있는 최신 실물 기록은 2026-08-13이다.
+이 폴더에 남아 있는 실물 연결 기록은 2026-08-13이다. 이후 SWEEPICK의 양팔·학습·실물 기록과 구분한다.
| 항목 | 현재 판단 |
|---|---|
diff --git a/so101_imitation_learning/README.md b/so101_imitation_learning/README.md
index 9701030c..0403f44a 100644
--- a/so101_imitation_learning/README.md
+++ b/so101_imitation_learning/README.md
@@ -1,5 +1,13 @@
# SO-101 Imitation Learning — 학습용 포크
+PyTorch → Transformer → ACT → SO-101·MuJoCo를 이어 읽는 교육용 코드다. 원본 예제와 개인 재현 기록을 구분하고, ACT 프로젝트의 공동 실험은 SWEEPICK에서 따로 연결한다.
+
+[PyTorch](101_pytorch_basic/) · [ACT 단계별 예제](103_ACT_step_by_step/) · [MuJoCo 기초](105_MUJOCO_basic/)
+
+[교육 전체 안내](../docs/LEARNING_GUIDE_KO.md) · [최신 SWEEPICK](../2ARM_ROBOT/README.md) · [저장소 첫 화면](../README.md)
+
+## 기록의 범위와 기존 실행 안내
+
PyTorch 기초에서 시퀀스 모델, ACT, SO-101 제어와 MuJoCo 실습으로 이어지는 학습 저장소입니다.
**원본:** [JD-edu/so101_imitation_learning](https://github.com/JD-edu/so101_imitation_learning) · **관리:** [전형주 / Alpenj](https://github.com/Alpenj) · **포트폴리오:** [Physical AI Portfolio](https://julianjeonresume.netlify.app/)
diff --git a/so101_ros2/README.md b/so101_ros2/README.md
index f633391c..6a361a9d 100644
--- a/so101_ros2/README.md
+++ b/so101_ros2/README.md
@@ -1,5 +1,13 @@
# DAPIER SO-101 ROS 2 Stack
+C++ 관절·지역화 계약과 ROS 2 노드를 나눠 읽는 구현 공간이다. 아래 상태표는 이 스택의 범위이며, SWEEPICK의 별도 실물 실행기 상태와 구분한다.
+
+[관절 코어](dapier_so101_core/src/joint_model.cpp) · [관절 테스트](dapier_so101_core/test/test_joint_model.cpp) · [지역화 코어](dapier_localization_core/README.md)
+
+[교육 전체 안내](../docs/LEARNING_GUIDE_KO.md) · [최신 SWEEPICK](../2ARM_ROBOT/README.md) · [저장소 첫 화면](../README.md)
+
+## 기록의 범위와 기존 실행 안내
+
SO-101의 실행 계층과 TurtleBot3 지역화 경계를 직접 이해하고 구성하기 위한 ROS 2
Jazzy 프로젝트다. LeRobot의 원클릭 실행 명령을 로봇 런타임으로 사용하지 않고,
Visual SLAM 지역화, 관절 계약, 안전 제한, 텔레옵, 하드웨어, 데이터 기록의 경계를
diff --git a/turtlebot3_ws/README.md b/turtlebot3_ws/README.md
index 73461beb..9dde85fc 100644
--- a/turtlebot3_ws/README.md
+++ b/turtlebot3_ws/README.md
@@ -1,5 +1,13 @@
# turtlebot3_ws — SLAM·Nav2 (ROS2 Jazzy)
+교재의 Humble·Gazebo Classic 예제를 Jazzy·Gazebo Harmonic에 맞추며 SLAM·Nav2·메시지 형식 차이를 기록한 워크스페이스다. 아래 설치·실행은 시뮬레이션 환경을 먼저 확인한다.
+
+[목표 전송 패키지](src/nav2_goals_py/) · [실행 보조 스크립트](scripts/README.md)
+
+[교육 전체 안내](../docs/LEARNING_GUIDE_KO.md) · [최신 SWEEPICK](../2ARM_ROBOT/README.md) · [저장소 첫 화면](../README.md)
+
+## 기록의 범위와 기존 실행 안내
+
wikidocs의 TurtleBot3 SLAM·Nav2 실습 교재를 이 워크스페이스에 맞게 이식했다.
교재는 **ROS2 Humble + Gazebo Classic** 기준이라 여러 군데를 이번 환경
(**ROS2 Jazzy + gz-sim/Harmonic**)에 맞게 바꿔야 했고, 그 과정에서 겪은 버그와